RAG는 모델을 다시 학습시키는 대신, 답변에 필요한 자료를 찾아 함께 넣는 방식입니다.
근거가 생겼지만,
검토는 여전히 필요했습니다.
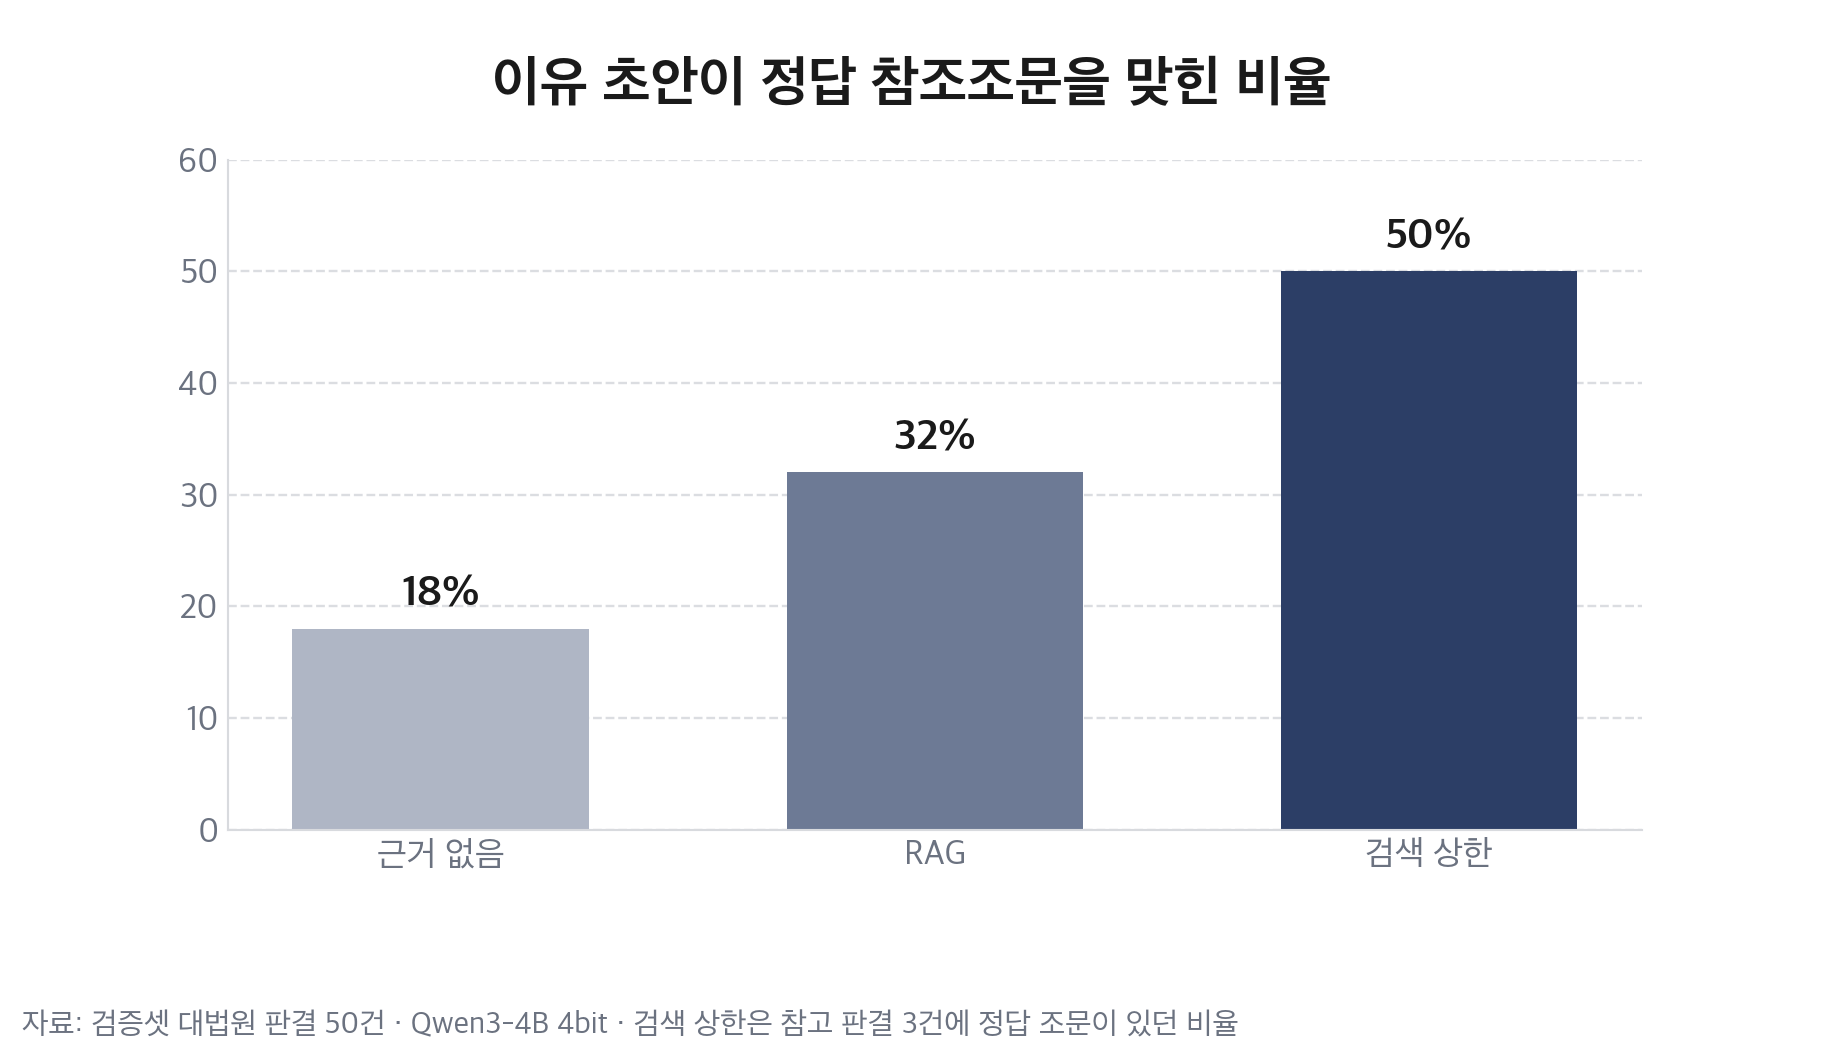
검증셋의 대법원 판결 50건에서 판시사항을 쟁점으로 주었습니다. 같은 Qwen3-4B 모델이 한 번은 참고 자료 없이, 한 번은 비슷한 판결 3건을 읽고 가상의 이유 초안을 썼습니다.
| 조건 | 조문 적중 | 조문 없는 초안 | 생성 시간 |
|---|---|---|---|
| 근거 없음 | 9/50건 · 18% | 23건 | 5.8초 |
| RAG | 16/50건 · 32% | 13건 | 15.0초 |
개선된 지표는 정답 참조조문을 맞혔는지입니다. 판결문의 전체 정확도나 법률 판단 능력을 뜻하지 않습니다. 참고 자료가 늘어 생성 시간도 약 2.6배 길어졌습니다.
RAG에서도 50건 중 34건은 이 기준을 맞히지 못했습니다. 생성 초안의 법령·조문·인용은 원문과 대조해야 합니다.
가명 처리 → 검색 → 초안 생성
AI Hub의 판결서 익명처리 데이터를 사용했습니다. 공개 판결문의 사람·조직·주소를 가명으로 바꾸는 라벨을 적용하고, 학습셋 16,800건을 검색용 코퍼스로 만들었습니다.
- 라벨 적용. 같은 인물은 같은 가명으로 연결합니다. 위치가 어긋난 라벨은 가장 가까운 한 곳을 찾아 보정하고, 코퍼스의 원문 잔존을 검사합니다.
- 문서 임베딩. 사건명·판시사항·판결요지·이유 앞부분을 이어 최대 1,800자로 제한합니다. 판결 한 건을 bge-m3 벡터 하나로 만들었습니다.
- 검색 후 생성. 쟁점과 가까운 판결 3건을 Qwen3-4B-Instruct-2507 4bit에 넣어 이유 초안을 생성했습니다.
문단 단위 chunking이나 복잡한 검색 서버 없이 만든 실습입니다. 임베딩과 생성은 로컬 모델을 사용했습니다.
임베딩이라고 항상
조문을 더 잘 찾지는 않았습니다.
판시사항과 참조조문이 있는 검증 826건으로 검색했습니다. 상위 5건에 같은 참조조문을 쓰는 판결이 하나 이상 있는 비율은 TF-IDF 54.5%, bge-m3 48.6%, 하이브리드 53.4%였습니다.
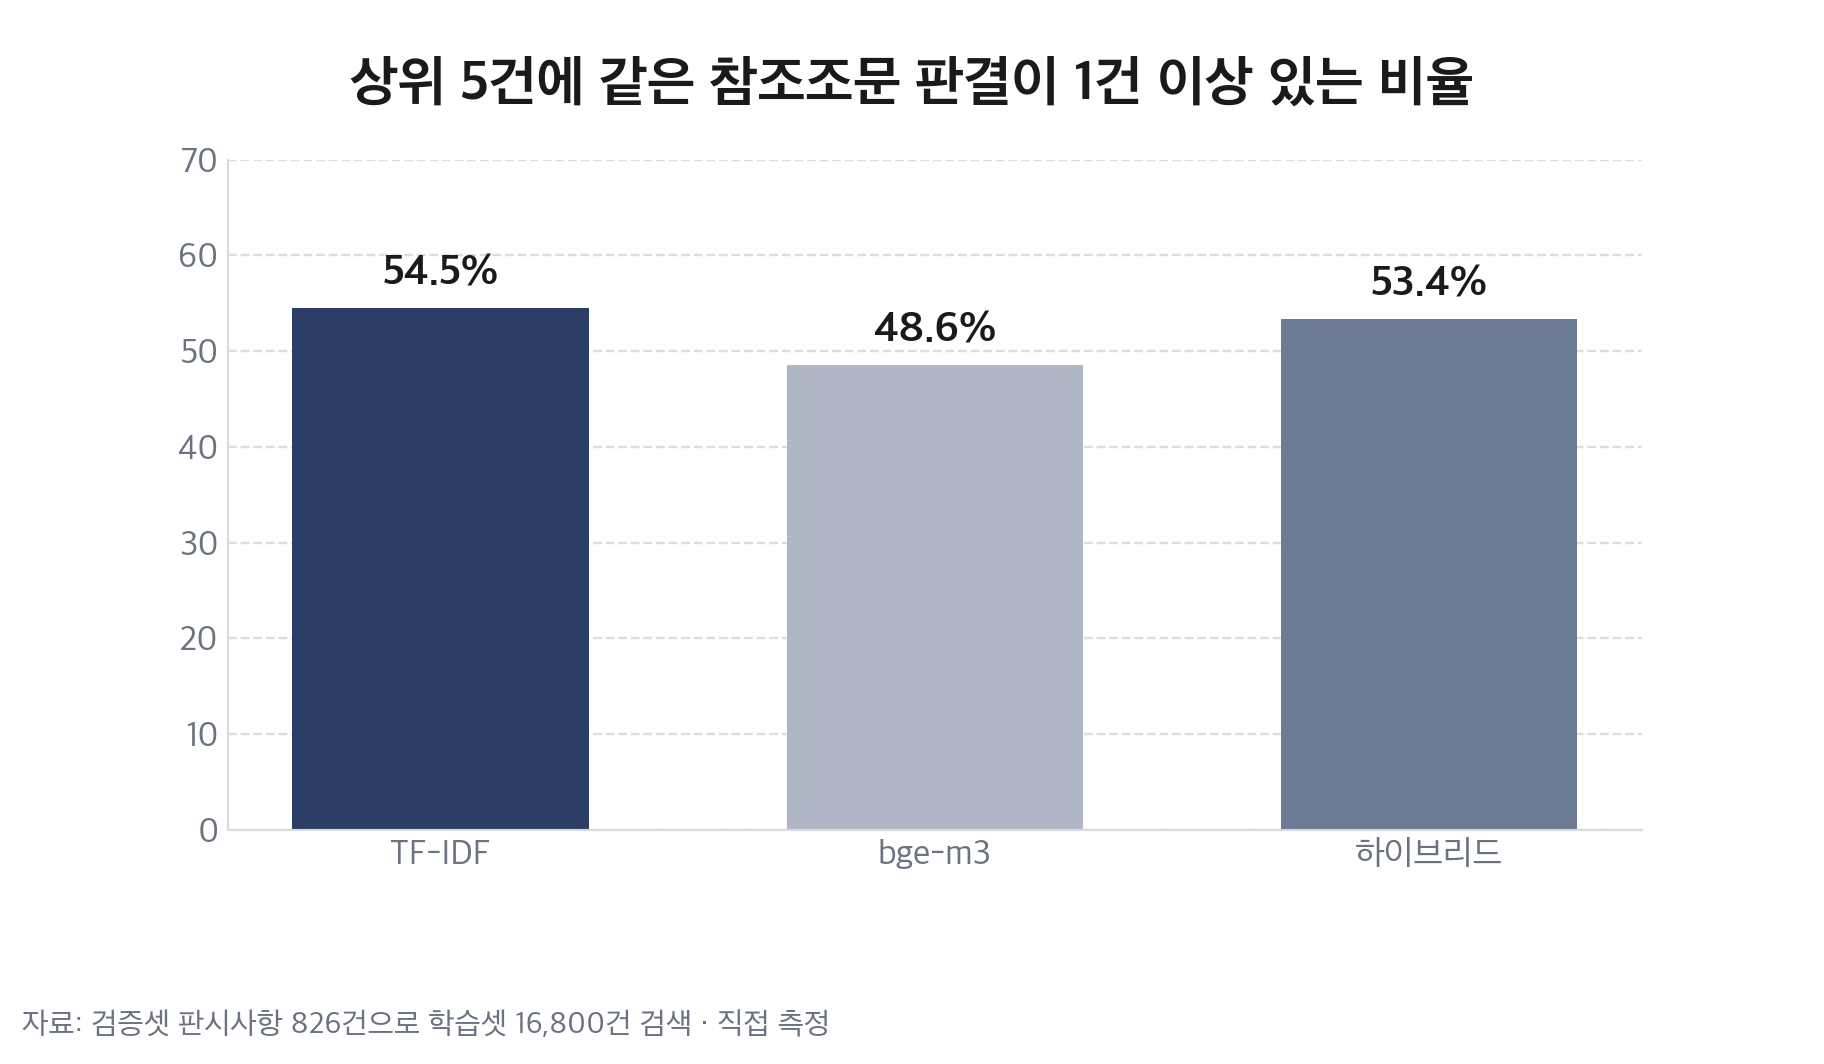
판시사항에 법령명과 조문 번호가 그대로 들어 있어 글자 기반 검색이 유리했던 것으로 보입니다. 반면 쟁점 한 건의 검색 시간은 bge-m3 71.6ms, TF-IDF 459.9ms로 임베딩 쪽이 더 빨랐습니다(5회 중앙값).
생성 실험에서는 검색한 3건 안에 정답 조문이 있는 쟁점이 25/50건이었습니다. 이번 구성에서 참고 판결이 제공하는 검색 상한은 50%였고, 검색을 개선할 여지가 남았습니다.
판결 임베딩 3D 지도 둘러보기 ↗내 컴퓨터에서 따라 해보기
먼저 AI Hub에서 데이터를 직접 신청하고 승인받아 내려받습니다. 아래 공개 노트북에는 원본 판결문·코퍼스·임베딩 파일이 들어 있지 않습니다.
실행은 로컬 PC에서 합니다. 이 데이터의 국외 반출·제3자 제공 조건 때문에 Colab이나 외부 LLM API로 판결문을 보내는 방식으로 바꾸지 않습니다. 상세 조건은 AI Hub 원문을 확인하세요.
1. 노트북과 실행 환경 준비
아래 노트북을 내려받은 폴더에서 명령을 실행합니다. Python이 설치돼 있어야 하며, 모델 관련 패키지는 노트북 첫 설치 셀이 기기에 맞춰 설치합니다.
# 로컬 Jupyter 실행 환경 준비 (Python이 설치된 PC)
python3 -m venv .venv
# macOS / Linux
source .venv/bin/activate
# Windows에서는 위 줄 대신: .venv\Scripts\activate
python -m pip install jupyterlab
python -m jupyter lab legal-rag-01.ipynb
2. 데이터 경로 지정 후 셀을 순서대로 실행
노트북의 DATA_DIR을 내려받은 2.데이터(NIA) 폴더 경로로 바꿉니다. 처음에는 LIMIT = 500으로 구성을 확인하고, 전체 실험과 구분해서 결과를 봅니다.
가명 코퍼스와 잔존 검사 → 임베딩 → 쟁점 검색 → 기기에 맞는 초안 생성 셀 순서입니다. Apple Silicon에서는 MLX, 다른 기기는 transformers 생성 셀을 사용합니다.
3. 같은 쟁점을 근거 있음·없음으로 비교
QUERY에 쟁점을 넣고 TOP_K = 3을 확인합니다. 출력의 조문이 참고 판결과 맞는지 비교합니다. 캐시가 문서 목록과 맞으면 다음 실행에서는 임베딩을 재사용합니다.
M3 Pro 36GB·노트북 기본 설정에서 전체 과정은 1회 59분, 임베딩은 55.4분이었습니다. 본문의 저부하 설정은 임베딩 84분으로 별도 측정입니다. 다른 PC의 실행 시간을 보장하는 값은 아닙니다.
바로 쓸 수 있는 자료
출처와 자세한 설명
시행착오·데이터 구조·전체 검색 비교는 네이버 원문에 기록했습니다.
네이버에서 자세한 글 읽기 ↗- AI Hub · 판결서 익명처리 데이터
- AI Hub · 데이터 이용정책
- BAAI · bge-m3 모델 카드
- MLX · Qwen3-4B-Instruct-2507 4bit
- No1Joon · 공개 실행 노트북
원문 발행 2026.09.30 · 웹 재구성 2026.10.03. 사진은 원문 완성 썸네일, 차트는 원문 실측 결과의 자가 렌더를 재사용했습니다. 이 자료는 과학기술정보통신부와 한국지능정보사회진흥원의 사업결과로 구축된 AI Hub 판결서 익명처리 데이터를 활용했습니다.